01
起点:产量上来了,信任没跟上
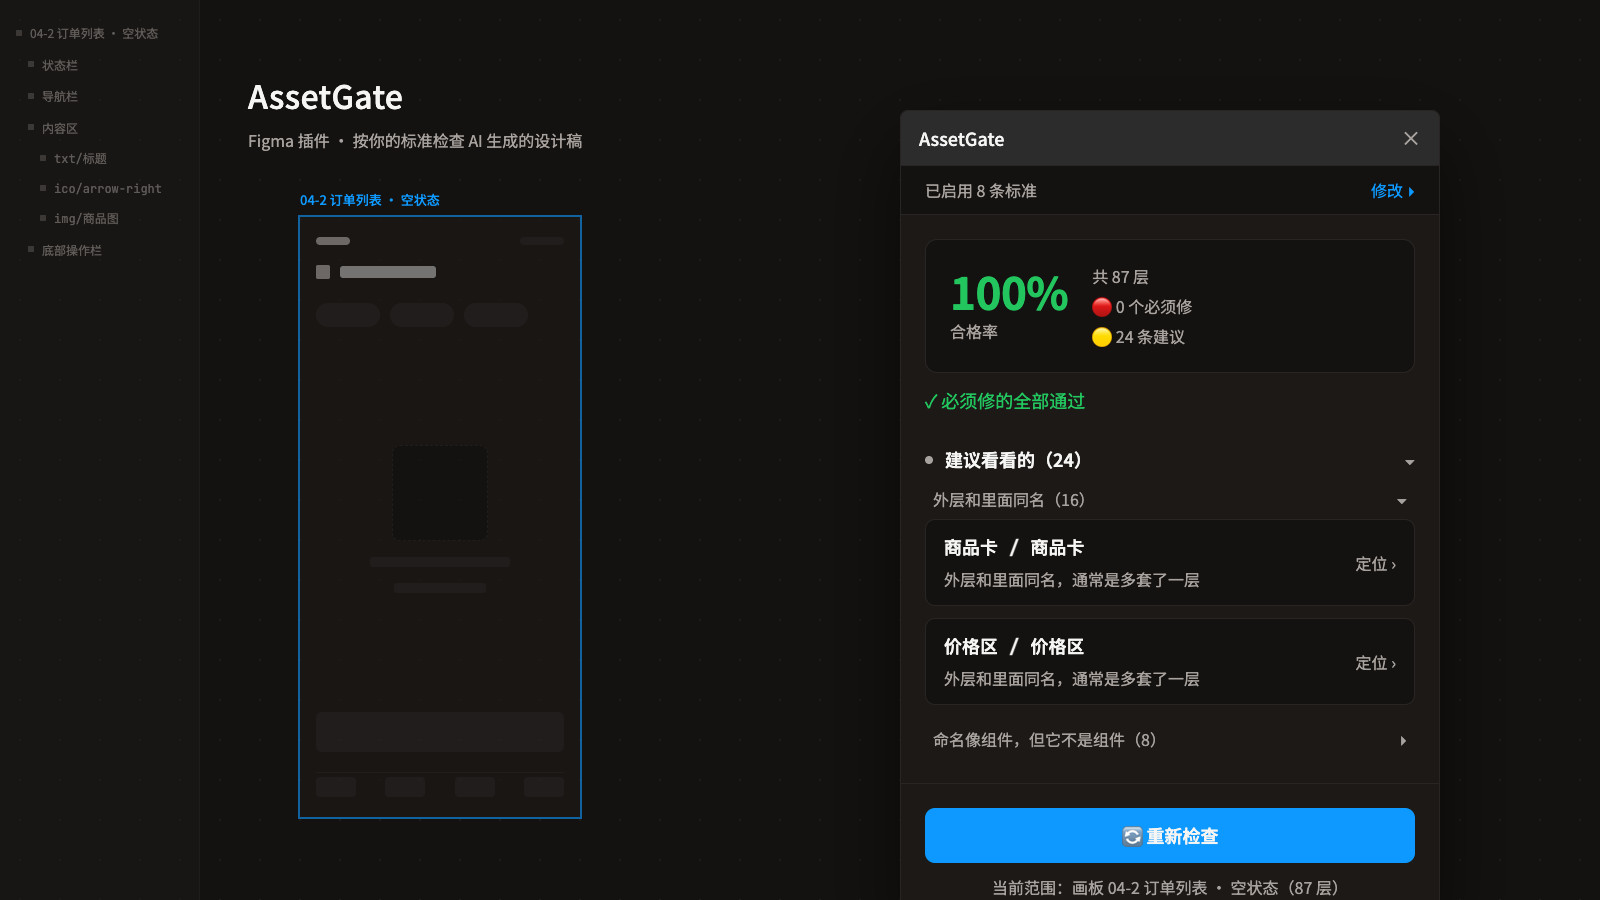
AI 现在一次能生成十几个界面,但我不敢直接拿来用。远看是对的,细看每一层的命名、层级、类型都可能是随手给的——图层叫 Frame 1、Container、Text,嵌套没有逻辑。人能看,机器不能用:没法批量导出、交接,也沉淀不成可复用的资产。 问题不在于 AI 做得不够快,而在于我没办法快速确认它做得对不对——逐层点开检查,比自己画一遍还慢。我想要的是一道二次校验。
02
定位:管线上的质量门
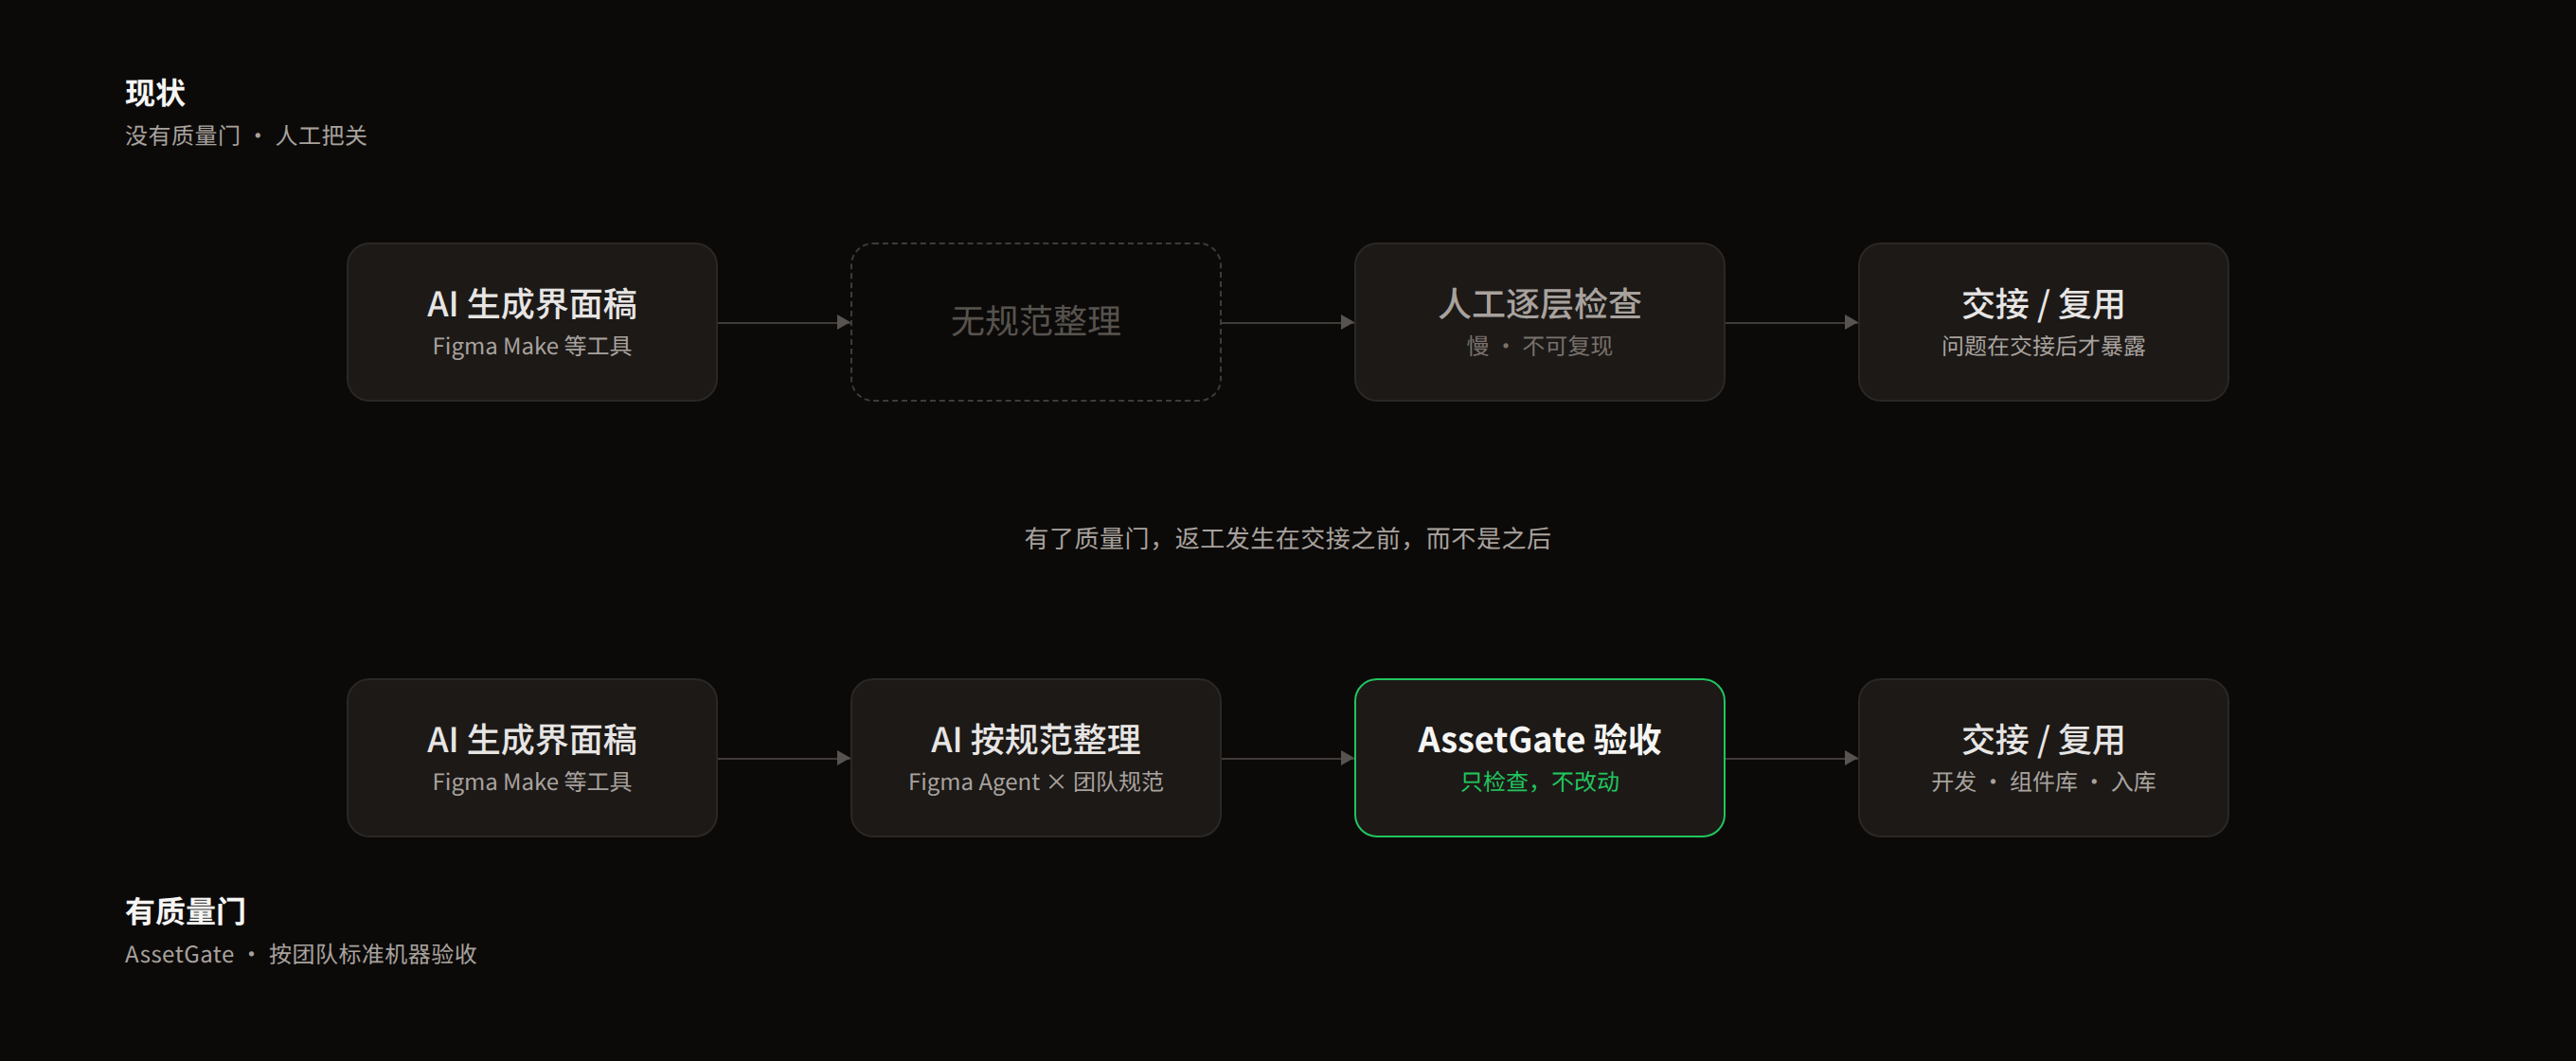
这一步目前是缺位的。现有插件大多停留在帮你改名字、查样式一致性,没有一个回答这份稿子达没达到可以交出去的标准——而产量越大,人工抽查越不可能。 AssetGate 补的就是这个位置:AI 生成 → AI 按规范整理 → AssetGate 验收。 标准写一次,机器执行一万次,返工发生在交接之前。
03
三个设计决策
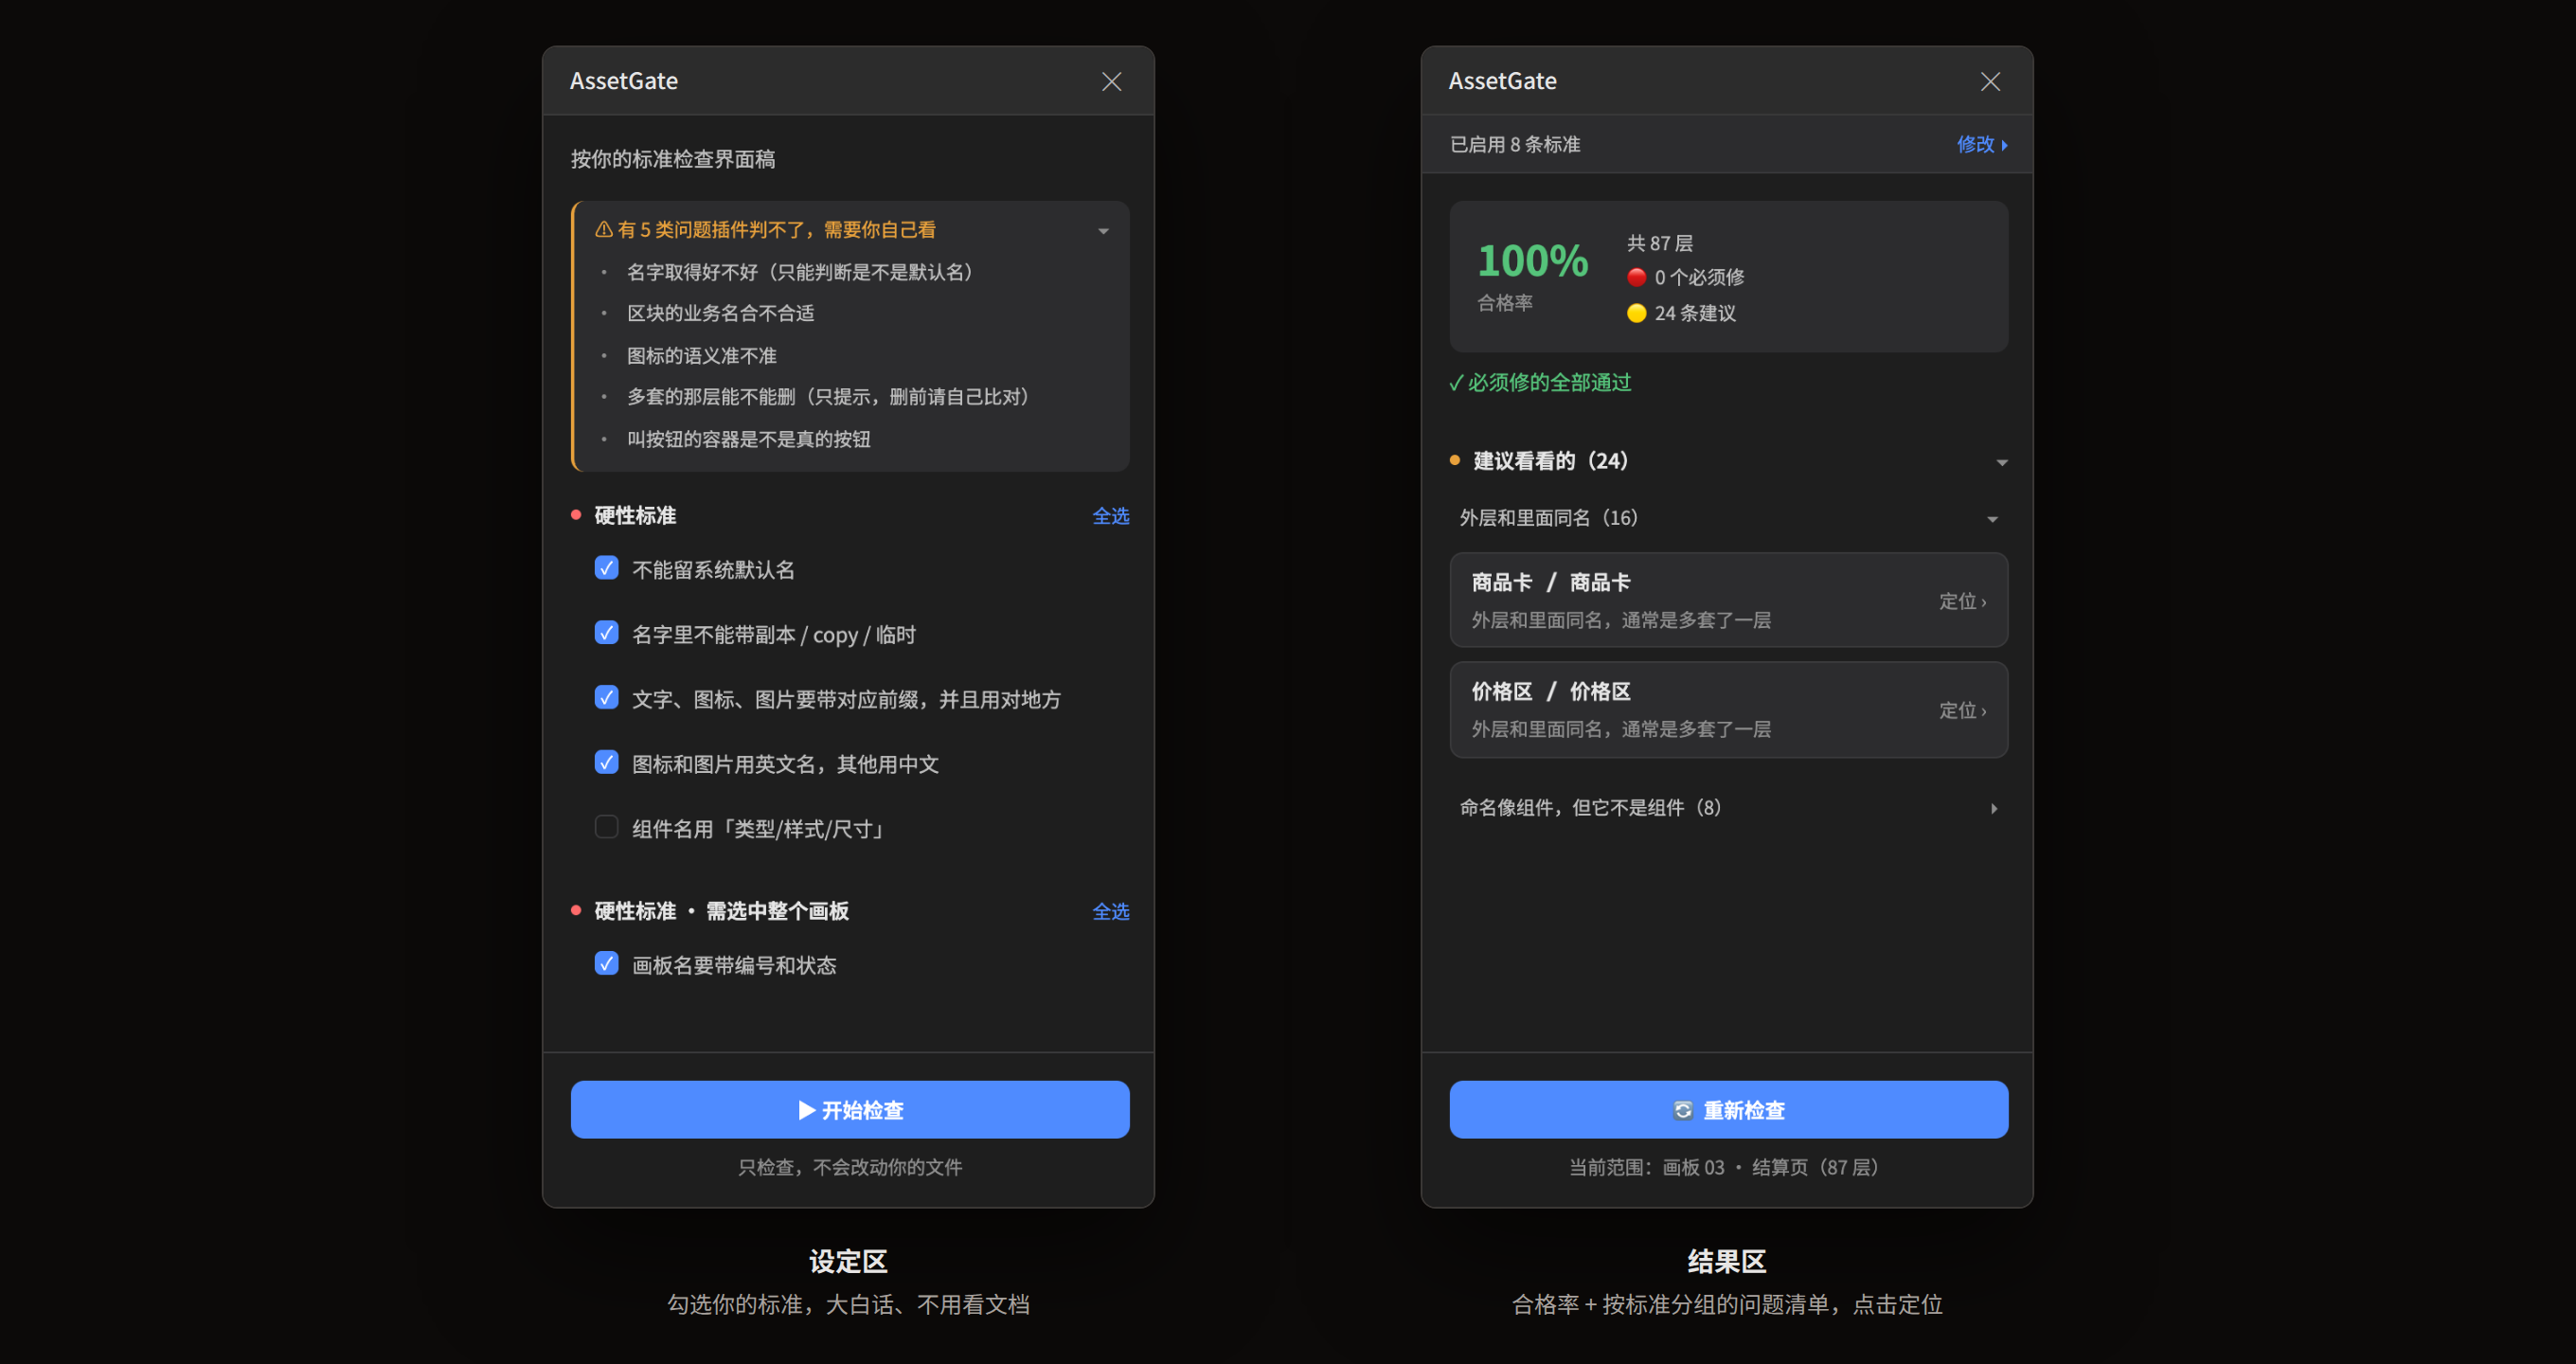
信任优先。 每条问题回显它违反的具体标准,点击即跳转定位,界面常驻"只检查,不改动文件";机器判不了的五类情况写在面板最顶部,不假装能判。 标准由使用者定义。 做的是"定义规范 + 执行检查"的能力,不是某一套具体规范。设定项全是大白话勾选,不需要懂正则。 只做客观可判的规则。 确定违规的计入合格率,启发式判断的只算建议——宁可少报,不可误报。
04
边用边调:三轮把误报清零
规则不是一次想清楚的,是拿 AI 生成的真实文件一轮轮试出来的。 第一版 28 个问题,19 个是误报——文字外面套的同名 Frame 被判"不是文字图层",emoji 图标被要求改成 txt/。第二版 9 个问题,全是误报。第三版归零。根因是同一个:我在做字符串匹配,而正确的做法是先看这个图层实际是什么。 每一轮都是同样的动作:拿真实稿子跑一遍 → 看哪条报错不合理 → 改规则 → 再跑。工具好不好用是磨出来的,不是一次设计出来的。
05
两级结果:必须修的,和值得看的
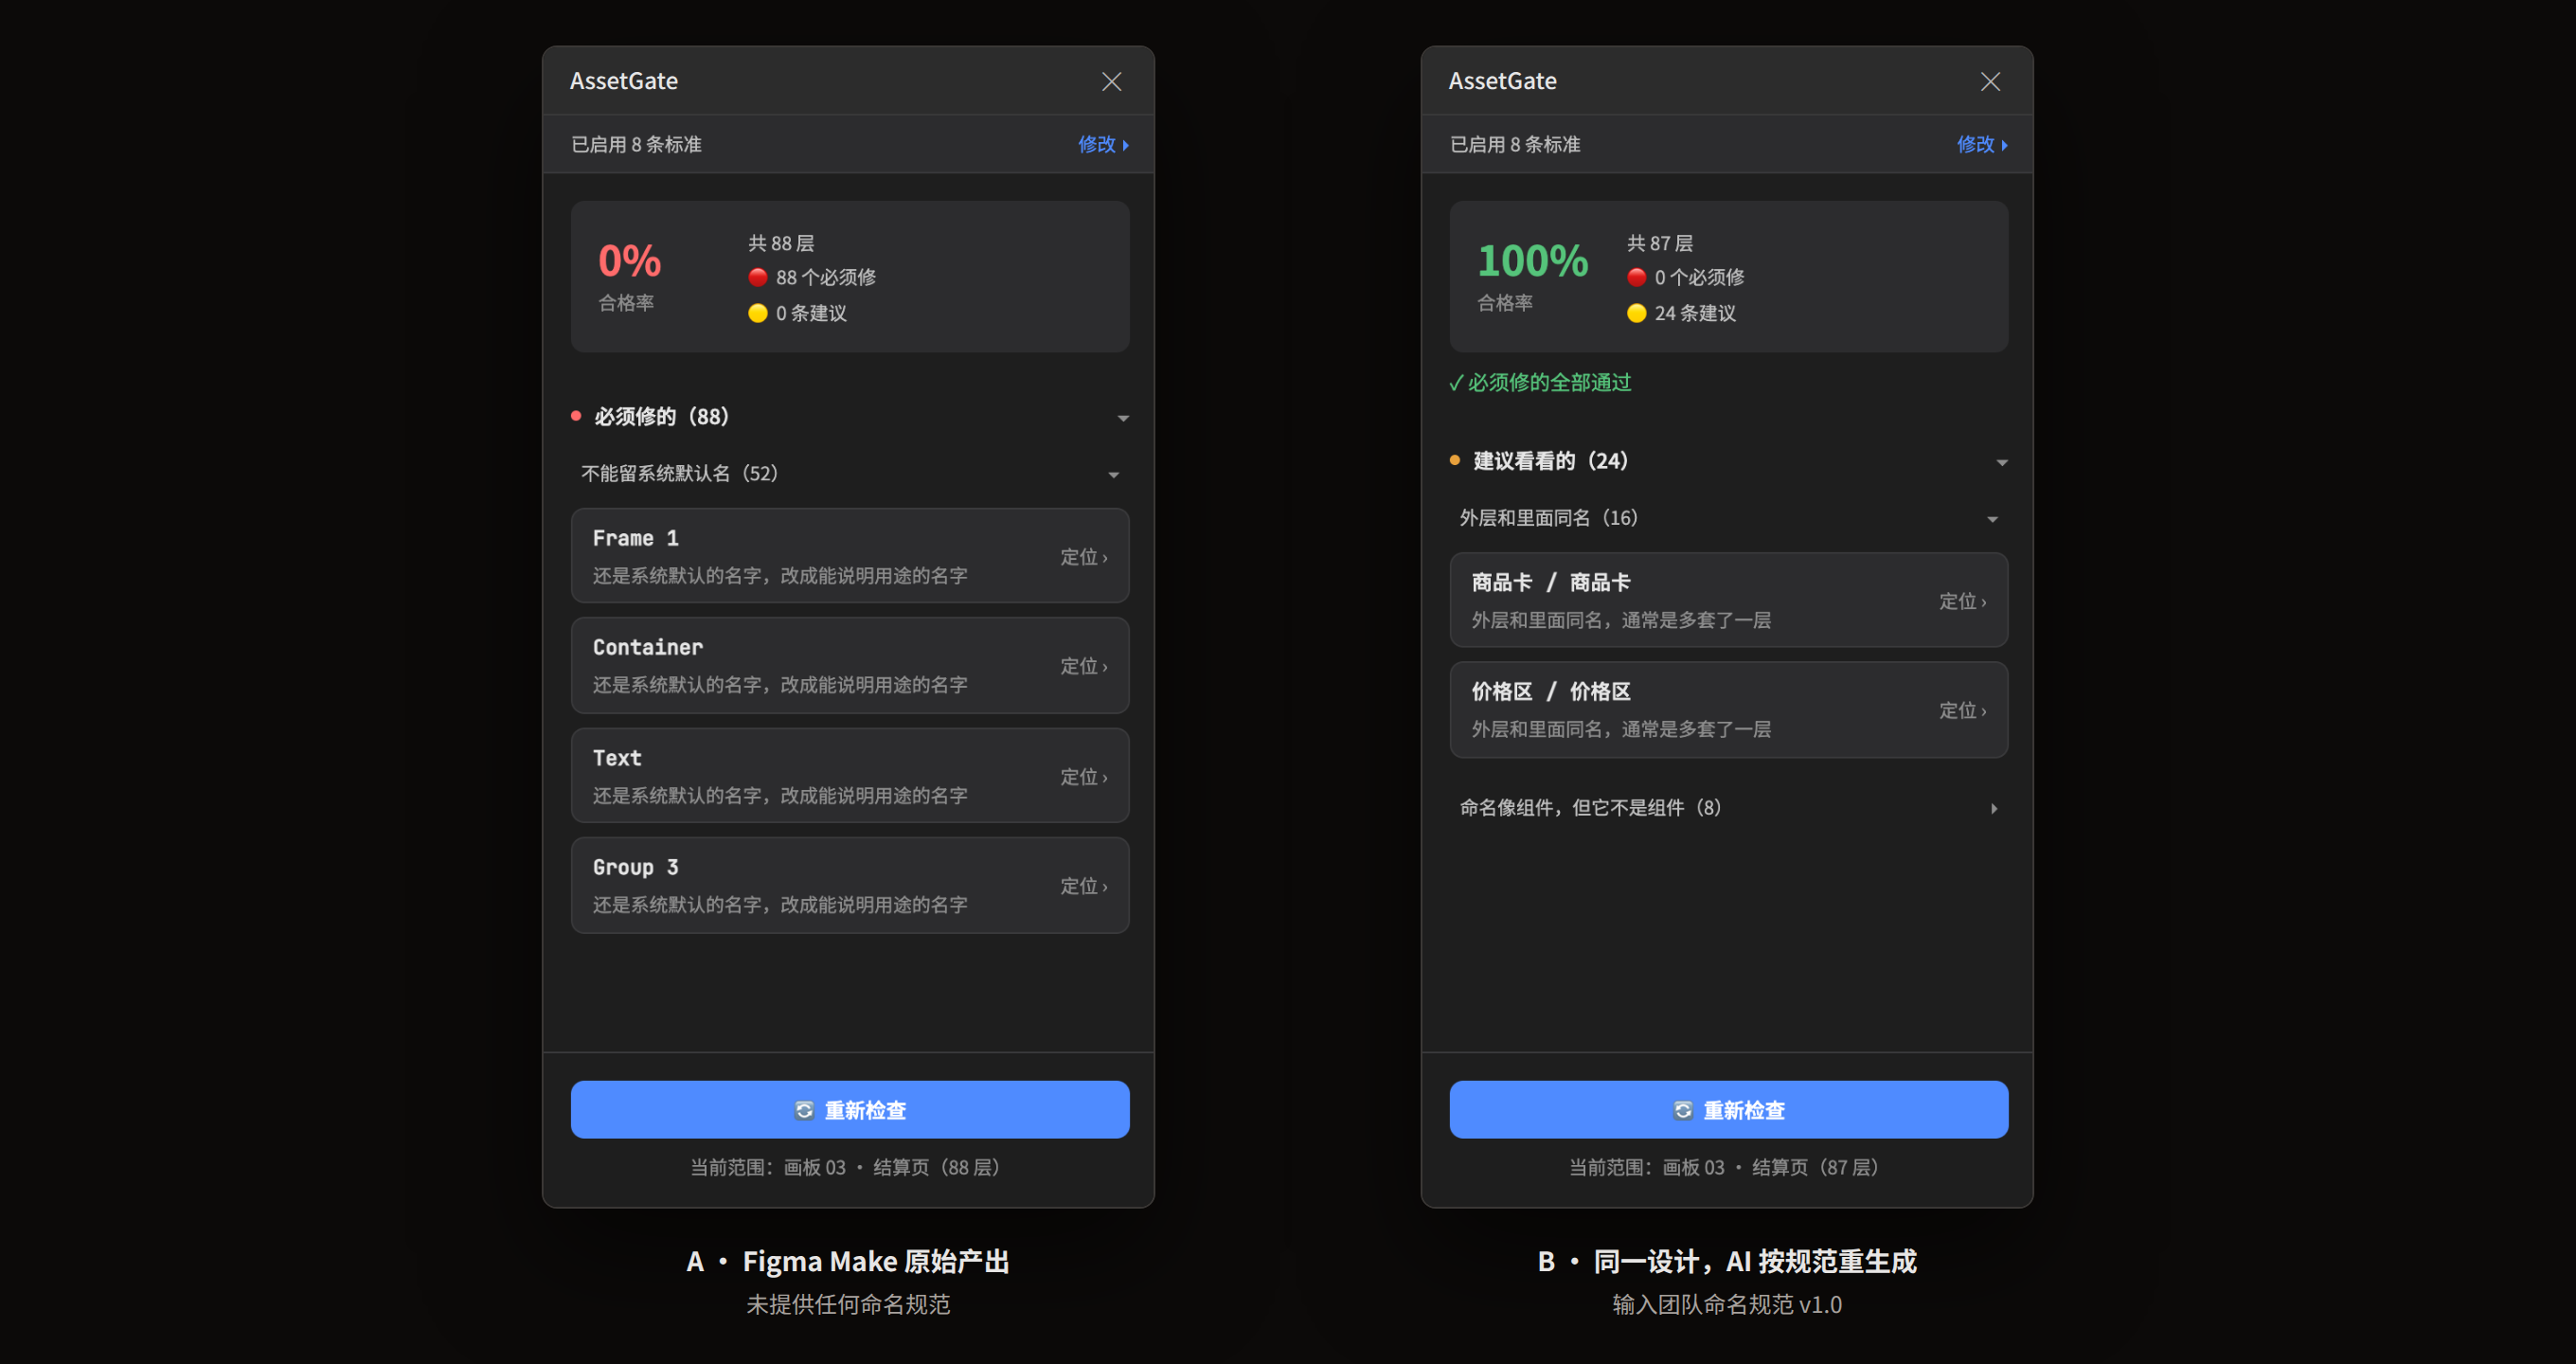
结果分两级:必须修的是客观违规,计入合格率;建议看看的是启发式判断,不计分。 同一套界面设计,Figma Make 原始产出 88 层、88 个必须修;把命名规范交给 AI 重新生成后 0 个必须修,但还剩 24 条建议——AI 会严格遵守你写下的规则,但不会做你没说的事,那 24 条全是规范里没写的两件事。 所以哪怕合格率 100%,那 24 条也值得看一眼。机器能判的是"有没有违规",判不了的是"这样做是不是更好"——把后者留成建议交回给人,比强行计分更诚实。
06
反思与下一步
如果重来,我会把标准前置到生成环节:在提示里就注入命名与结构要求,让 AI 生成时就合规,检查器只做兜底。事后拦截,永远比事前约束贵。 更完整的形态是把链路打通:生成时注入标准 → 自动整理 → 机器验收 → 合格资产打标入库。 现在 AssetGate 只占第三环。下一步接上 Figma Agent,等链路闭合,它就不只是一个插件——这也是我理解的 AI 时代设计工具该走的方向:不是替设计师做决定,而是把设计师定下的标准,变成机器可以反复执行的东西。